Vom Firmennamen zum CRM-Datensatz: Eine AgentCore-Konversation, End-to-End
Hinweis: Dieser Artikel wurde mit Unterstützung von KI aus dem englischen Original übersetzt.
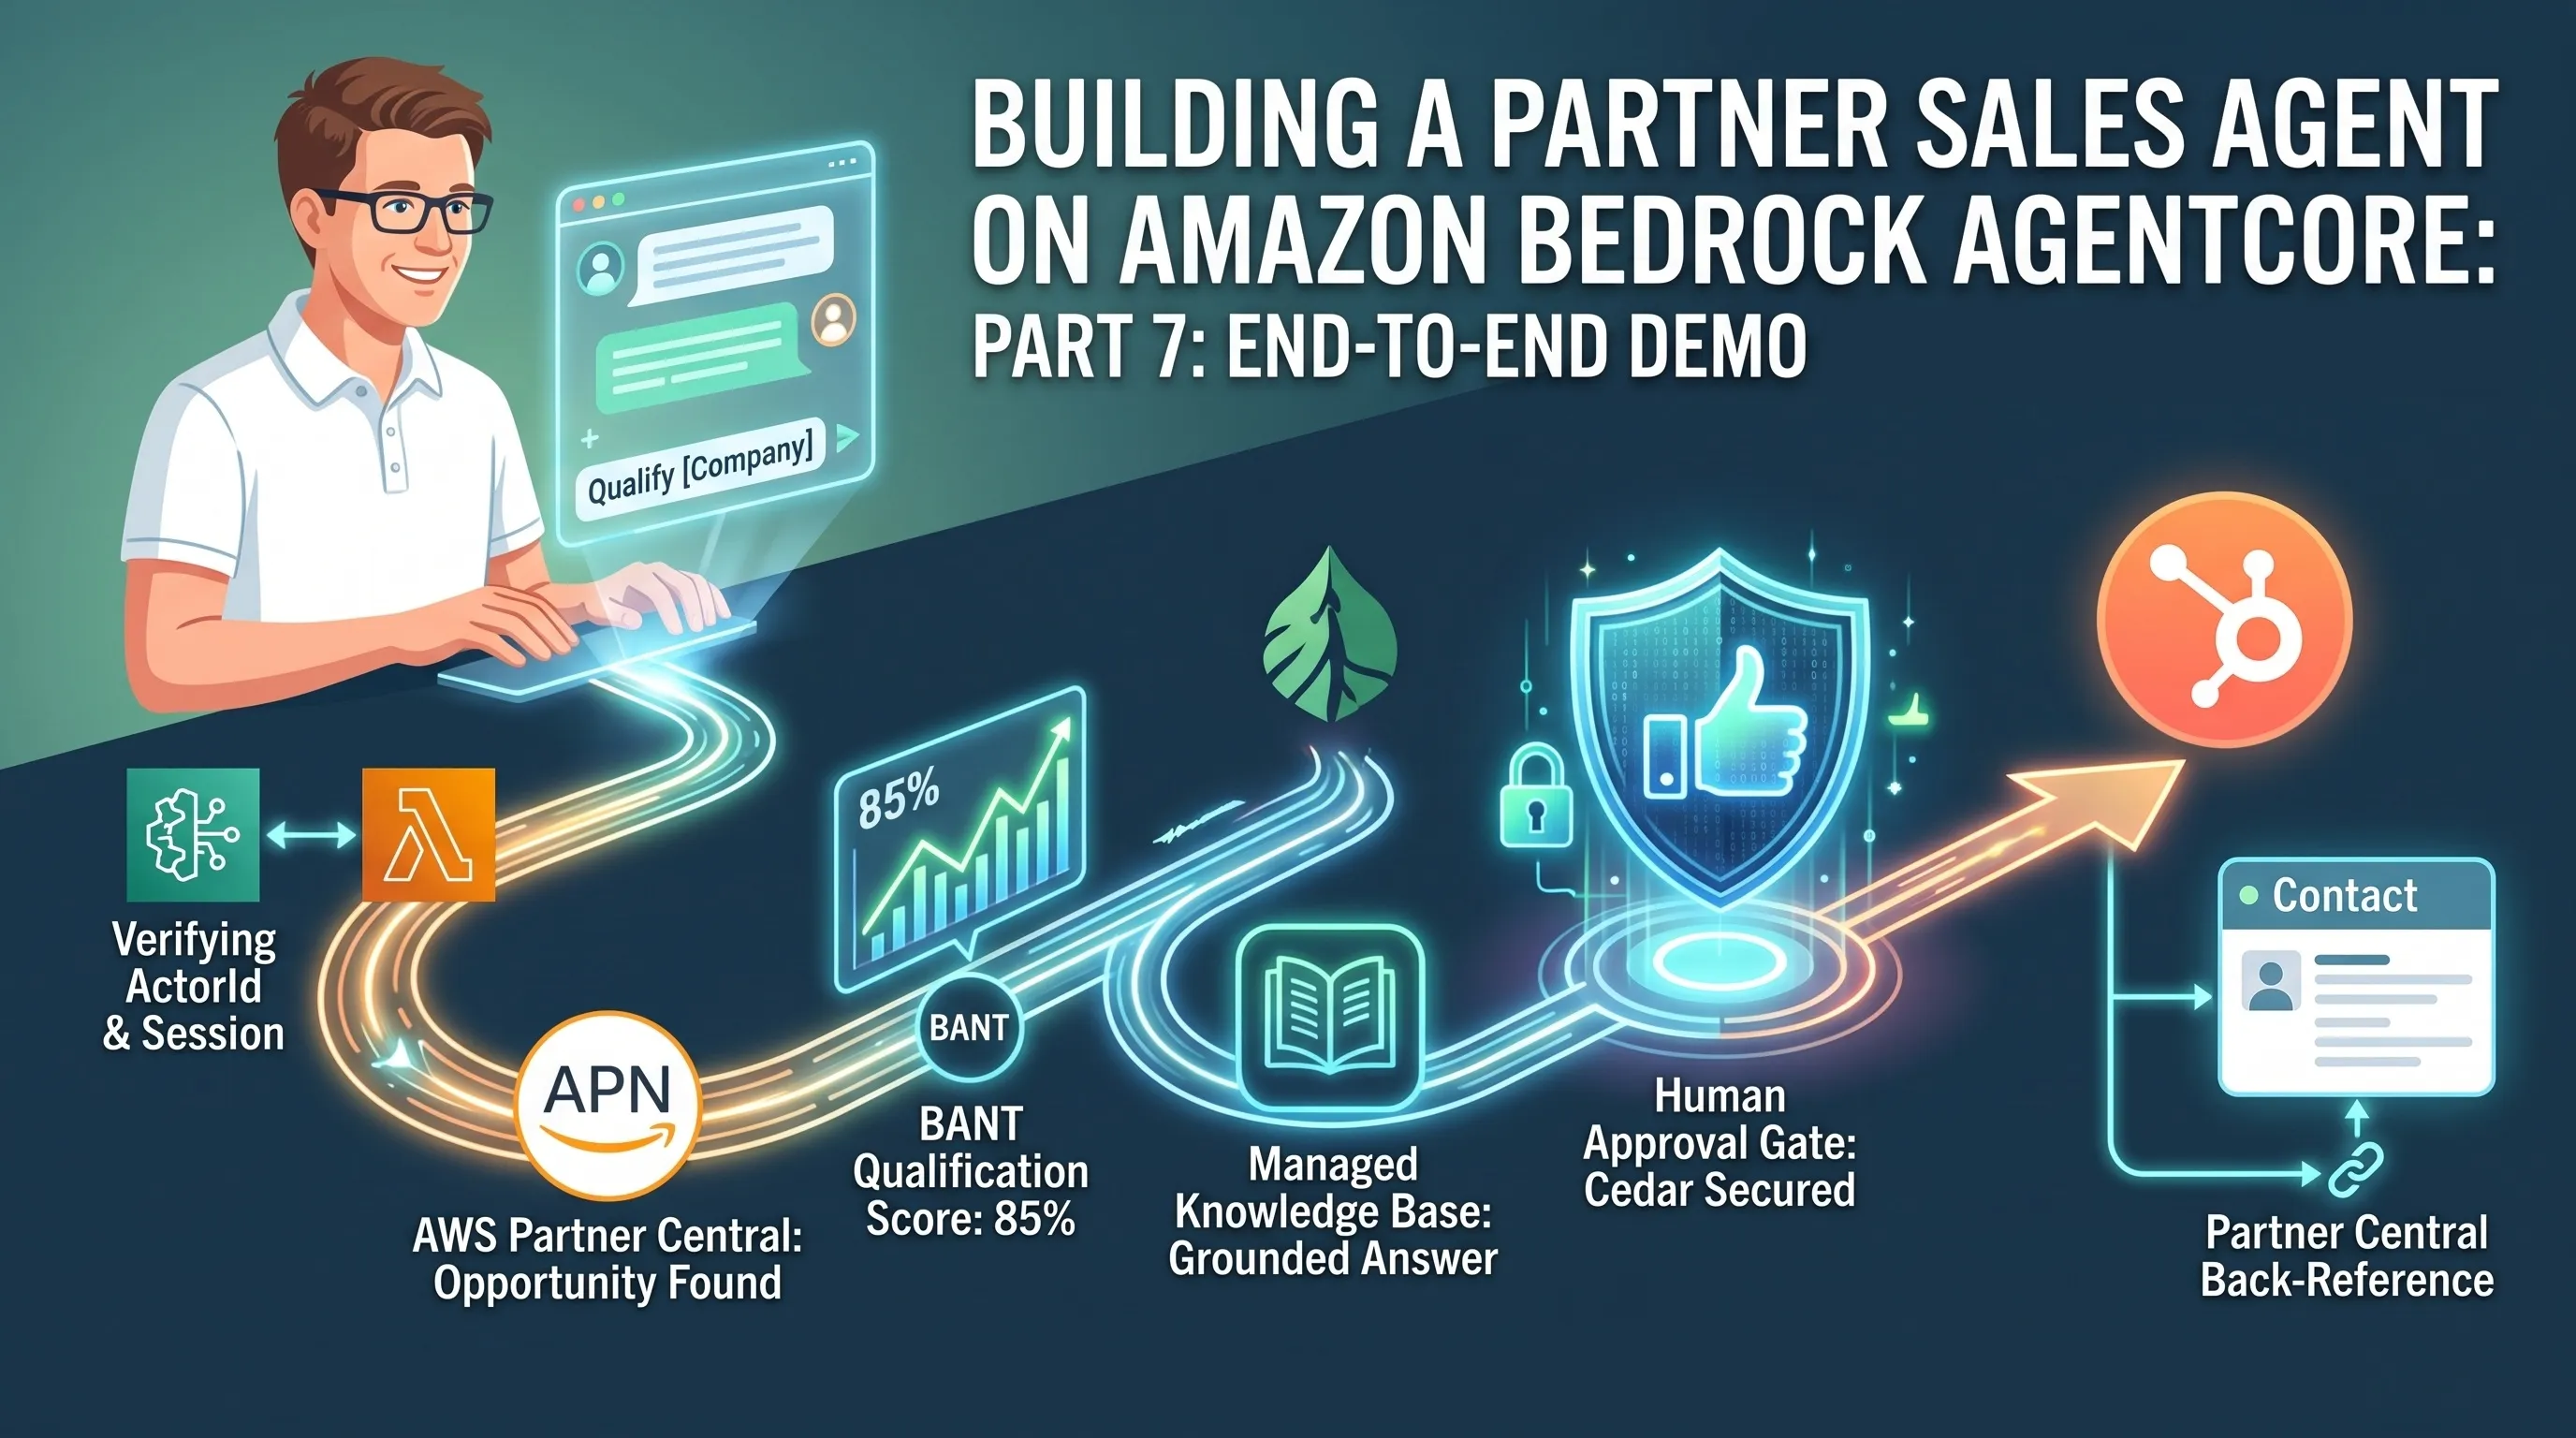
TL;DR: Ich habe dieses gesamte System live durchgespielt, von einem in die Chatbox eingetippten Firmennamen bis zu einem HubSpot-Contact mit Rückverweis auf AWS Partner Central, und erzähle genau nach, was sich dabei bewegte: den Wire-Contract, die actorId-basierte Identitätsisolation, die BANT-Qualifizierung, die Antwort aus der Knowledge Base, das dialogbasierte Approval-Gate hinter einem Cedar-Guard und den abschließenden CRM-Write.
Teil 7 der Serie „Einen Partner-Sales-Agent auf Amazon Bedrock AgentCore bauen“, aufgebaut um ein reales Projekt: ein dialogbasierter Agent, der HubSpot CRM und AWS Partner Central für das Sales-Team eines AWS-Partners verbindet. Dies ist der Abschlussartikel. Die ersten sechs haben das System Baustein für Baustein aufgebaut; dieser hier lässt es live laufen, von einem in eine Chatbox eingetippten Firmennamen bis zu einem HubSpot-Contact mit Rückverweis auf Partner Central. Er zieht außerdem die abschließende Bilanz der Serie: was auf Anhieb funktionierte, was einen Live-Fix brauchte und was als akzeptierte, offengelegte Grenze bestehen bleibt.
Inhaltsverzeichnis
- Artikel 1: Zwei Systeme, ein Vertriebsprozess: Ein AWS-Partner-Agent auf Amazon AgentCore Harness
- Artikel 2: Warum ich keine eigene Agent-Loop geschrieben habe: Das Argument für AgentCore Harness
- Artikel 3: AgentCore Runtime konfigurieren: Session-Lifecycle, Container-Backing, Memory
- Artikel 4: Ein Gateway, sechs Tools: AgentCore Gateway als einziger Weg nach außen für Ihren Agent
- Artikel 5: Ein deterministisches Sicherheitsnetz für Ihren Agent: AgentCore Policy und Cedar
- Artikel 6: Einen Agent ohne Vektordatenbank grounden: AgentCore Managed Knowledge Base
- Artikel 7: Vom Firmennamen zum CRM-Datensatz: Eine AgentCore-Konversation, End-to-End
Artikel 1 eröffnete diese Serie mit einem Versprechen: eine einzige Chat-Konversation trägt die gesamte Bewegung. Ein Sales-Mitarbeiter tippt einen Firmennamen ein, der Agent findet die passende Partner-Central-Opportunity, qualifiziert sie gegen die BANT-Kriterien (Budget, Authority, Need, Timeline), beantwortet eine Competency-Frage aus der Knowledge Base, schlägt einen HubSpot-Contact vor, wartet auf eine explizite menschliche Freigabe und schreibt den Contact mit einem Rückverweis auf die Opportunity, aus der er stammt. Jeder Baustein, den diese Konversation berührt, hatte seinen eigenen Artikel: die managed Agent-Loop, die Runtime-Konfiguration, das Gateway mit seinen sechs Targets, die Cedar-Policy-Engine hinter dem Write-Pfad und die Managed Knowledge Base. Jede Komponente für sich funktionierte gut, doch in der finalen Integration gab es durchaus Reibung.
Dieser Artikel erzählt daher eine reale Konversation durch das ausgerollte System nach und zeigt, was sich tatsächlich bewegt: den Wire-Contract an der Haustür, die Tool-Calls, die SSE-Frames, den Approval-Austausch und den Contact, der am Ende in HubSpot landet. Wo der Rundgang eine Stelle passiert, die mich beim Build gebissen hat, halte ich an und zeige den Biss.
Haustür: eine Anfrage vom Browser zum Harness bringen
Bevor das Modell auch nur ein Wort sieht, müssen einige Infrastruktur-Teile erst stehen. Der Browser lädt die statische Chat-UI von CloudFront, angemeldet über Cognito, und sendet den Turn jetzt als einen einzigen HTTP-Call.
POSTan die API-Gateway-Invoke-URL mitContent-Type: application/jsonund dem Body{"prompt": "<text>", "sessionId": "<uuid, optional>"}.- Der
Authorization-Header trägt das rohe Cognito-ID-Token ohneBearer-Prefix. Der nativeCOGNITO_USER_POOLS-Authorizer von API Gateway erwartet das nackte JWT, keinen OAuth-artigen Wrapper. - Der allererste SSE-
data:-Frame, den der Client empfängt, ist immer{"sessionId": "<resolved-uuid>"}, ausgegeben noch vor jedem Modellinhalt, damit der Client die Id persistieren kann, noch bevor das erste Token eintrifft.
Ein authentifizierter Call über diesen Contract lieferte zwischen 9 und 17 diskrete data:-Frames pro Antwort, fortlaufend gedruckt statt als ein einziger blockierender Schub – das zeigt, dass es echtes Live-Streaming ist und keine gepufferte Antwort.
Hinter dem Cognito-Authorizer von API Gateway sitzt das Streaming-Relay, die eine Lambda im Projekt, die ihre eigene Python-Regel bricht und auf nodejs24.x läuft, weil Lambda-Response-Streaming ausschließlich auf Node-verwalteten Runtimes existiert [1]; ihre Integration zeigt auf die response_streaming_invoke_arn der Funktion mit response_transfer_mode = "STREAM" [2], bei einem Timeout von 90 Sekunden.
Der eigentliche Job des Relays ist jedoch die Identität. Es leitet zwei Identifikatoren pro Request ab, und die tragen sehr unterschiedliches Gewicht:
// lambda/streaming_relay/handler-logic.mjs (verdichtet)export function deriveActorId(event) { const sub = event?.requestContext?.authorizer?.claims?.sub; if (typeof sub !== "string" || sub.length === 0) { throw new Error( "deriveActorId: event.requestContext.authorizer.claims.sub is missing " + "or empty -- refusing to invoke the harness without a verified actorId." ); } return sub;}export function resolveSessionId(body) { const sessionId = body?.sessionId; if (typeof sessionId === "string" && sessionId.length > 0) { return sessionId; } return randomUUID();}actorId stammt aus dem verifizierten sub-Claim des JWT und aus nichts anderem. Nicht aus dem Request-Body, nicht aus einem Header, und falls der Claim einmal fehlen sollte, wirft die Funktion, bevor überhaupt ein Harness-Call zustande kommt. sessionId ist der Wert des Clients, falls vorhanden, sonst eine frische UUID. Die Unterscheidung ist wichtig, weil die beiden Ids unterschiedliche Aufgaben erfüllen. sessionId gruppiert Events zu einer Konversation für die History- und Recall-UI und trägt selbst kein Sicherheitsgewicht. actorId ist das, worauf AgentCore Memory tatsächlich partitioniert. Ein Leser, der beide vermischt, nimmt an, dass die Eindeutigkeit der Session-Id die Isolationsarbeit übernimmt – tut sie aber nicht, wie der nächste Abschnitt mit einer absichtlich kollidierten Id zeigt.
Wie im ersten Artikel beschrieben: AgentCore Harness liefert einen nativen Inbound-JWT-Authorizer, der es dem Browser erlaubt hätte, den Harness direkt aufzurufen, und dieser Weg verlor, weil nichts darin einen verifizierten Claim an actorId bindet [3]. Einfach gesagt: Ich wollte den Harness-Invoke absichern und das JWT-Token validieren, bevor der Harness überhaupt aufgerufen wird. Das erlaubte mir außerdem, die Authentifizierungslogik aus dem Harness-Code herauszuhalten.
Das Lambda-Relay trägt noch ein weiteres Detail: sein IAM-Grant.
# infra/lambda_streaming_relay.tf (verdichtet) -- das einzige AgentCore-Grant des Relaysdata "aws_iam_policy_document" "streaming_relay_invoke_harness" { statement { effect = "Allow" actions = [ "bedrock-agentcore:InvokeHarness", "bedrock-agentcore:InvokeAgentRuntime", ] resources = [ aws_bedrockagentcore_harness.agent.arn, # harness/<id> "${aws_bedrockagentcore_harness.agent.arn}/harness-endpoint/*", # safe superset ] }}Zwei IAM-Actions mit verwirrend ähnlichen Namen existieren im selben bedrock-agentcore-Namespace und dürfen hier niemals auftauchen: InvokeAgentRuntimeCommand und InvokeAgentRuntimeCommandShell [3]. Das sind direkte Command-Ausführung und eine interaktive Shell gegen die Runtime, und beide umgehen das Modell und seine Tool-Allowlist vollständig. Sie haben nichts mit dem sicheren InvokeHarness/InvokeAgentRuntime-Paar zu tun, das ein Relay braucht, von denen keines ein Command-Suffix trägt. Die Resource-Liste ist ein bewusstes Superset, sowohl der nackte Harness-ARN als auch seine /harness-endpoint/*-Sub-Resource.
Identität innerhalb derselben Session, präzise formuliert
Die Session-Isolation lässt sich leicht mit den folgenden Schritten testen, die ich selbst durchgeführt habe:
-
Zwei Cognito-User anlegen.
-
Nutzer A hat dem Agent in Session
Seine einprägsame Tatsache mitgeteilt ("meine Lieblingsfarbe ist gelb"). -
Nutzer B hat daraufhin exakt denselben
sessionId-StringSwiederverwendet und den Agent gebeten, sich daran zu erinnern. Nutzer B bekam "Ich habe keine Erinnerung daran." -
Eine Folgefrage von Nutzer A in derselben Session
Serinnerte die Farbe korrekt.
Das ist ein klareres Ergebnis als "unterschiedliche Sessions bleiben getrennt": dieselbe wortwörtliche Session-Id, abgefragt von zwei verschiedenen Akteuren, liefert jeweils die eigene Partition jedes Akteurs und nie die des anderen. Die Partitionierung erfolgt auf der verifizierten Identität, noch bevor überhaupt die Session-Id angefragt wird.
Die Konversation: vom Firmennamen zur qualifizierten Opportunity
Hier ist der Ablauf mit jedem Baustein aus den Artikeln 3 bis 6, in der Reihenfolge, in der die Demo sie durchläuft.
Der Sales-Mitarbeiter eröffnet mit einem Firmennamen: "Qualifiziere [Firma] gegen die BANT-Kriterien." Der erste Call des Agents ist list_matching_opportunities, das einen gesprochenen, umgangssprachlichen Firmennamen zu einer Opportunity im APN-Portal auflöst. Gibt es mehrere Opportunities mit demselben Namen, liefert das Tool eine Liste von Opportunities zurück, und der Sales-Mitarbeiter muss den Kandidaten auswählen.
Da der Listen-Call nicht genug Informationen liefert, um die Kandidaten auseinanderzuhalten, wird pro Opportunity in der Liste ein GetOpportunity ausgeführt. Das liefert Projekttitel, Kontakte, Stage, das Ziel-Close-Gate und den erwarteten Umsatz.
Ist die Opportunity identifiziert, zieht get_opportunity den vollständigen Datensatz plus eine bant_source_fields-Ansicht, in der jedes fehlende Feld als der wörtliche String "Not stated in opportunity data" gerendert wird. Die Qualifizierung, die das Modell produziert, muss zwischen Beleg und Fehlen unterscheiden, und dieser Contract lebt in der Tool-Ausgabe, nicht im Ermessen des Modells. Auch hinter diesem Call steht eine Absicherung: eine Cedar-Regel an der AgentCore-Gateway-Grenze verbietet jeden get_opportunity-Call ohne opportunity_id, unabhängig davon, was das Modell erzählt.
Die BANT-Antwort selbst folgt exakt dem im System-Prompt festgelegten Ausgabeformat: jedes der vier BANT-Felder bewertet von 0 bis 10 mit stützenden Evidenz-Bulletpoints, die Summe aus 40 als Prozentsatz ausgedrückt, ein Status von exakt PURSUE, PURSUE WITH CAUTION oder DISQUALIFY, dann eine Gewinnwahrscheinlichkeits-Schätzung und eine empfohlene nächste Aktion.
Zur Klarstellung: Ich habe 2 Wege gebaut, um auf AWS Partner Central zuzugreifen – über Lambda und direkte API sowie über MCP Server. Der MCP Server, der dem Harness als reason_about-Tool erscheint, sollte in diesem Fall nicht verwendet werden, weil die Antwort dann keine BANT-Source-Fields enthalten würde. Ich habe den Prompt umstrukturiert und die Verstoßrate von 33 % auf 11 % gesenkt.
Zwei weitere Verhaltensweisen runden das Qualifizierungsbild ab. Eine Opportunity in einer Co-Sell-Bewegung kann zwei unterschiedliche Account-Teams tragen: die eigenen Vertriebsmitarbeiter des Partners auf der Opportunity und ein separates AWS-seitiges Team (Sales Rep, Account Owner, Partner Development Manager), das aus einer völlig anderen API stammt, GetAwsOpportunitySummary. Das Tool führt diese AWS-seitigen Felder in dieselbe get_opportunity-Antwort zusammen, und die System-Prompt-Regel verlangt, dass der Agent die beiden Teams als getrennt beschriftete Gruppen präsentiert, "Ihr Team:" und "AWS-Team:", niemals als eine undifferenzierte Namensliste. Im finalen Live-Test gegen eine echte Co-Sell-Opportunity trat das AWS-seitige Team genau so zutage. Ein Sales-Mitarbeiter, der fragt "wem gehört dieser Deal", bekommt eine Antwort, die dem entspricht, was Partner Central tatsächlich anzeigt.
Und wenn der Sales-Mitarbeiter zu "was ist unser Competency-Ansatz hier?" wechselt, wird der Turn über AgenticRetrieveStream zur Managed Knowledge Base geroutet, und die Antwort kommt gegroundet in den abgerufenen Dokumenten zurück, mit ihren Quellen in einer einzigen Liste am Ende gesammelt. Artikel 6 behandelt, was diesen Index füttert; in der Konversation ist es ein weiterer Tool-Call.
Das Approval-Gate: vorschlagen, dann nach HubSpot schreiben
Der eine Write-Pfad im gesamten System ist hs-write___upsert_contact, und der Mechanismus, der ihn absichert, ist nicht der, den ich entworfen habe. Die ehrliche Abfolge zählt mehr als der finale Mechanismus, also zuerst der nicht eingeschlagene Weg.
Der ursprüngliche Entwurf war ein dediziertes propose_hubspot_contact-Tool vom inline_function-Typ des Harness: das Modell ruft es auf, der Harness pausiert, ein Mensch gibt frei, die Ausführung geht weiter. Zwei separate Verdrahtungen dieser Idee wurden gebaut, und beide erwiesen sich als nicht tragfähig – entdeckt erst durch Live-Tests am Checkpoint. Erstens: Ein per Terraform deklariertes inline_function-Tool lässt sich über keinerlei allowed_tools-Pattern erreichen, sobald der Harness eine restriktive Allowlist hat. Die dokumentierte Pattern-Tabelle deckt *, einfache Namen (die nur je eingebaute Tools matchen), @builtin[/name] und @server[/tool] für Gateway- und MCP-Tools ab. Für die Tool-Typen inline_function, browser oder code_interpreter gibt es überhaupt kein Pattern, also tauchte das deklarierte Tool nie beim Modell auf. Zweitens: Ein zur Invoke-Zeit übergebener tools=[...]-Parameter ersetzt für diesen Call das gesamte konfigurierte Toolset des Harness, statt es zu ergänzen, was Invoke-Zeit-Injection für jeden Flow ausschließt, der die dauerhaften Tools und die Pause in derselben Session braucht.
Was ausgeliefert wurde, ist eine Konsequenz aus beiden Sackgassen: Es gibt überhaupt kein Propose-Tool. Das Modell durchsucht, ausgestattet nur mit seinen dauerhaft konfigurierten Tools, zuerst HubSpot, verfasst den vollständigen vorgeschlagenen Contact-Datensatz als Klartext (E-Mail, Vorname, Nachname, Firma und den für das message-Feld bestimmten Opportunity-Verweis) und beendet seinen Turn mit einer Freigabefrage.
Das Signal, das die Pause auflöst, änderte sich einmal nach dem Go-live, und die Änderung ist einen Satz Geschichte wert. Die erste funktionierende Version erkannte exakt einen wörtlichen String als Freigabe an, "APPROVED: proceed with the HubSpot write now.", plus ein "NOT APPROVED"-Gegenstück, und behandelte alles andere, inklusive "ok" und "sure", als Rauschen. Das funktionierte, verschweißte aber eine HubSpot-spezifische Phrase in den Prompt und in jeden Client. Der aktuelle Prompt verallgemeinert denselben Contract zu einem toolagnostischen Tag, das das Modell als letztes in seinem Vorschlags-Turn ausgibt:
# infra/harness.tf, System-Prompt (verdichtet auf die Regel des Approval-Signals)Rule 8c (the decision-request signal, generic and non-negotiable): Immediatelyafter presenting the full proposed record in plain text (Rule 8b) and askingthe presenter to approve it, emit EXACTLY one decision-request tag as the verylast thing in your turn, then end your turn:<decision_request>{"question": "<restate the yes/no question in one sentence>","options": ["Approve", "Decline"]}</decision_request>... Only treat the presenter's NEXT message as resolving this decision-requestif it is an EXACT, case-sensitive match for one of the option labels you justoffered (e.g. exactly "Approve" or exactly "Decline") -- any other reply(including something that merely sounds like agreement, e.g. "ok", "sure","yes go ahead") is neither; re-state the proposal and the tag again ratherthan guessing. NEVER call hs-write___upsert_contact withconfirmed_by_presenter=true except immediately after receiving the exact"Approve" reply for THIS exact proposal ... There is no session fast-path, ever.Im Browser rendert dieses Tag nie als Rohtext; das Frontend extrahiert es mitten im Stream und rendert eine Approve/Decline-Karte, und ein Klick auf einen Button sendet das exakte Label als nächsten User-Turn. Außerhalb des Browsers steuert ein kleines CLI-Skript denselben zweistufigen Austausch – auch der übersichtlichste Weg, die Form des Mechanismus zu sehen:
# scripts/approve_hubspot_write.py (verdichtet) -- der zweistufige Approval-Treiberresponse = invoke_fn( harnessArn=harness_arn, runtimeSessionId=session_id, messages=[{"role": "user", "content": [{"text": args.prompt}]}],)proposal_events = list(response["stream"]) # a boto3 EventStream iterates onceproposal_text = extract_text(proposal_events)print(proposal_text) # the model's own proposed Contact recorddecision = parse_decision_request(proposal_text) # fail-closed: None on anything malformedfor index, option in enumerate(decision["options"], start=1): print(f" {index}) {option}") # 1) Approve 2) Declinechosen_label = decision["options"][int(input("Choose an option number: ")) - 1]followup = invoke_fn( harnessArn=harness_arn, runtimeSessionId=session_id, # the SAME session: turn two of one conversation messages=[{"role": "user", "content": [{"text": chosen_label}]}], # exact label, verbatim)Ein rein per Prompt durchgesetztes dialogbasiertes Gate wäre für sich genommen eine dünne Sache, und das ist es hier nicht. Der deterministische Guard ist die Cedar-Regel aus Artikel 5: Jeder Call an hs-write___upsert_contact, dessen Input confirmed_by_presenter fehlt oder es auf etwas anderes als true setzt, wird an der Gateway-Grenze verboten, unabhängig davon, was das Modell behauptet zu tun.
Eine ehrliche Grenze dieses Guards: Er verifiziert, dass das Flag vorhanden und auf true gesetzt ist, nicht, dass eine echte menschliche Freigabe es erzeugt hat. Ein Modell, das confirmed_by_presenter=true ohne echte Freigabe anhängt, käme durch. Cedar sieht den Input eines einzelnen Calls, nie die Konversation, die dazu führte, also bleibt die Verifikation echter Zustimmung auf Prompt-Ebene als akzeptiertes, dokumentiertes Restrisiko.
Streaming zum Browser
Ich möchte noch genauer auf das Live-Token-Streaming zwischen Browser und Harness eingehen:
Ein Tool-nutzender Harness-Turn multiplext drei Message-Zyklen über eine einzige HTTP-Antwort. Zyklus eins ist der Tool-Call: messageStart, die Tool-Use-Content-Blöcke, messageStop mit stopReason: "tool_use". Zyklus zwei ist das zurückkommende Tool-Ergebnis, abgeschlossen durch sein eigenes messageStop. Zyklus drei ist die eigentliche Antwort, der einzige Zyklus mit Text, den ein Nutzer sehen soll, gestreamt als contentBlockDelta-Frames und abgeschlossen durch messageStop mit stopReason: "end_turn".
Landung in HubSpot, mit einem Rückverweis auf Partner Central
Ein freigegebener Write beendet die Konversation genau dort, wo das Sales-Team ohnehin arbeitet. Der Contact landet in HubSpot CRM, mit den Kernfeldern (E-Mail, Vorname, Nachname, Firma) auf HubSpots eigene Standard-Properties gemappt, und die AWS-Partner-Central-Verknüpfung wird in die bestehende message-Property geschrieben, ein freies Standard-Textfeld, das dieses Projekt wiederverwendet, statt ein eigenes anzulegen. Der Text folgt einer festen Form: "Primary contact on Partner Central opportunity <opportunity-id> (<company> / <reseller>, '<project title>', Partner Opportunity Identifier <partner-opp-id>)." Ein Mitarbeiter, der diesen Contact im nächsten Quartal öffnet, sieht genau, welche Opportunity ihn hervorgebracht hat, ohne das CRM zu verlassen.
Das Drumherum: History- und Memory-Einstellungen
Neben der Demo-Konversation gibt es zwei weitere unterstützende Seiten in der Demo-Anwendung.
Die History-Seite listet die bisherigen Konversationen eines Nutzers mit Vorschau und Zeitstempel auf, spielt Transkripte ab und bietet Löschen pro Zeile an. Transkripte aus AgentCore Memory wieder auszulesen, hat etwas Zeit gekostet. Event-Payloads verpacken den Anzeigetext eine Ebene tiefer, als die dokumentierte Form nahelegt, also wendet das Backend ein zweites json.loads() an, um an den tatsächlichen Nachrichtentext zu kommen. Events kommen neueste zuerst zurück, die Liste muss also vor der Wiedergabe neu sortiert werden, sonst rendert jede Konversation rückwärts.
Löschen ist etwas schwieriger. Ein Hard-Delete der Events einer Session funktioniert, aber die leere Hülle der Session verschwindet nie aus der list_sessions-Antwort; ich habe nach dem Löschen jedes Events gepollt, und die Hülle blieb, weil keine serverseitige API eine Session entfernt, deren Events weg sind. Der Fix ist ein clientseitiger Filter in der Lambda, eine billige Ein-Event-Existenzprüfung (session_has_events) pro Session. Noch tiefer liegt: Drei der vier Memory-Strategien (Semantic, User Preference und Episodic Reflection) tragen überhaupt keine Session-Lineage-Metadaten, sodass sich beim Löschen einer Konversation nicht sauber nur deren gelernte Fakten mitlöschen lassen. Die einzige Lösung ist ein akteursweiter Wipe, und der Bestätigungsdialog stellt klar: Das Löschen dieser Konversation entfernt auch Fakten und Präferenzen, die der Agent aus den anderen Konversationen des Nutzers gelernt hat.
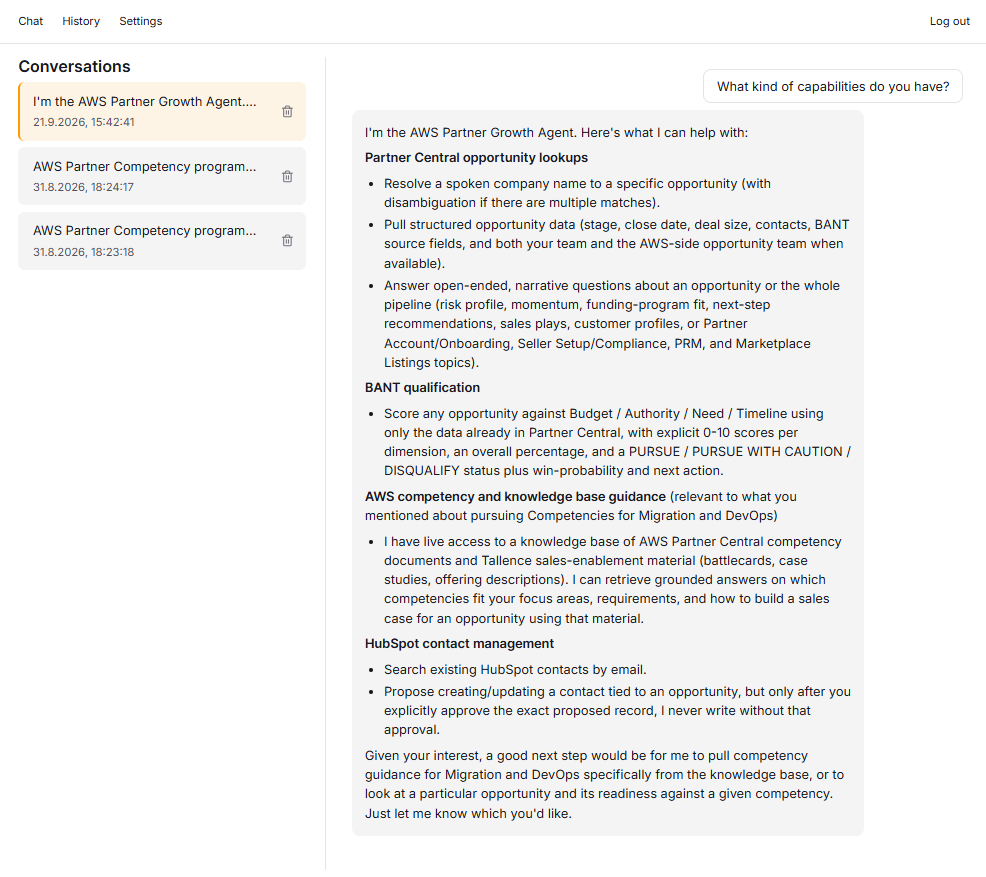
Die Settings-Seite besteht aus vier beschrifteten Schaltern, einer pro Memory-Strategie (Semantic, Summary, User Preference, Episodic). Die Seite legt zwei reale Grenzen offen. Eine Strategie auszuschalten unterdrückt nur das Retrieval; das Hintergrundlernen läuft weiter. Der Effekt ist Harness-global, er erreicht jeden gleichzeitigen Nutzer des gemeinsamen Demo-Harness, nicht nur die Person, die den Schalter umgelegt hat – ein akzeptiertes Zugeständnis für eine Ein-Rep-Demo, offengelegt statt verschwiegen. Der Schalter ist nicht rein kosmetisch: Der Live-Abnahmetest hat eine Strategie ausgeschaltet, bestätigt, dass der Agent den Langzeitkontext dieser Strategie in derselben Konversation nicht mehr abrief, sie wieder eingeschaltet und bestätigt, dass der Recall bei der nächsten Nachricht zurückkehrte – der Zustand überlebte sogar einen Seiten-Reload.
Übertragbare Muster
Sieben Artikel produzieren jede Menge projektspezifisches Detail. Diese vier Gewohnheiten sind der Teil, den ich in jeden AgentCore-Build oder überhaupt jeden Agent-Build mitnehmen würde.
actorIdaus dem verifizierten JWT-subableiten, niemals aus dem Request-Body. Das ist der tatsächliche Isolationsmechanismus in diesem gesamten System. Ein client-seitig übergebener Nutzer-Identifikator jeder Art ist ein spoofbarer Input; ein Claim aus einem Token, das der Server selbst validiert hat, ist es nicht.- Ein SSE-Consumer darf nicht beim ersten gesehenen
messageStopabbrechen. Jeder Tool-nutzende Agent-Turn multiplext mehrere Message-Zyklen über eine HTTP-Antwort. Ein Streaming-Consumer, der gegen ein Ein-Zyklus-Mentalmodell geschrieben ist, verwirft still die finale Antwort jedes Tool-nutzenden Turns – genau so, wie es das Frontend dieses Projekts einmal tat – und besteht dabei jeden Tool-freien Test. - Isolation mit einer echten IDOR-Probe verifizieren, nicht nur mit UI-Abwesenheit. Zu bestätigen, dass die Daten eines anderen Nutzers in der UI nicht auftauchen, beweist, dass die UI korrekt filtert, und nichts sonst. Den Read-Endpoint direkt mit einem nicht zusammenpassenden Akteur-Session-Paar abzufragen, ist der Check, der ein serverseitiges Leck ausschließt, und ihn mit einer garantiert frischen Session-Id durchzuführen, macht das Ergebnis eindeutig.
- Niemals
InvokeAgentRuntimeCommandoderInvokeAgentRuntimeCommandShellgewähren. Diese beiden IAM-Actions umgehen das Modell vollständig, für direkte Command-Ausführung und eine interaktive Shell [3]. Sie haben nichts mit dem sicherenInvokeHarness/InvokeAgentRuntime-Paar zu tun, das ein Relay braucht, und der richtige Zeitpunkt, sie herauszudesignen, ist beim ersten Schreiben der Policy, nicht bei einem Review Monate später.
Was es tatsächlich gekostet hat
Es war nicht der reine Happy Path:
Der messageStop-Bug verschluckte still die gerenderte Antwort jedes Tool-nutzenden Turns – genau der Turns, für die diese Demo existiert –, bis eine instrumentierte Aufzeichnung des rohen Streams fand, dass die Loop beim ersten von drei Message-Zyklen abbrach. Das ausgelieferte Approval-Gate war der dritte Entwurf, aufgebaut auf zwei inline_function-Verdrahtungen, die gebaut, live getestet und als unerreichbar oder selbstsabotierend befunden wurden. Der Cedar-Guard auf dem einen Write-Pfad tut genau das, was er kann, und nicht mehr: Er lehnt deterministisch jeden Write ab, der nicht als true geflaggt ist, und kann nicht verifizieren, dass ein Mensch das Flag erzeugt hat. Und das Löschen einer Konversation trägt einen offengelegten akteursweiten Memory-Wipe, weil drei der vier Memory-Strategien keine Pro-Session-Lineage besitzen, an der man das entlangschneiden könnte.
Der Punkt, direkt formuliert: Dieses System ist vollständig aus Managed Services gebaut, ohne selbstgehostete Inferenz und ohne eigene Orchestrierungs-Loop, und es brauchte trotzdem Live-Debugging, einen verworfenen Entwurf und eine akzeptierte, offengelegte Grenze, um zu einer funktionierenden Demo zu kommen.
Damit endet auch diese Serie. Artikel 1 versprach, dass eine Konversation die gesamte Bewegung tragen kann, und die Konversation, die dieser Artikel durchlaufen hat, ist dieses eingelöste Versprechen: ein Firmenname als Input, eine qualifizierte Opportunity, eine gegroundete Competency-Antwort, eine explizite menschliche Freigabe und ein HubSpot-Contact als Output, mit dem Rückverweis, der die beiden Systeme of Record ehrlich zueinander hält.
Ich hoffe, dieser Artikel war hilfreich für Sie. Ich freue mich über Feedback, was Ihnen gefallen hat und was nicht, damit ich künftige Artikel verbessern kann.
Quellen
[1] AWS-Lambda-Entwicklerhandbuch: Response Streaming (streamifyResponse) ist ausschließlich auf Node.js-Managed-Runtimes verfügbar. https://docs.aws.amazon.com/lambda/latest/dg/configuration-response-streaming.html
[2] Amazon-API-Gateway-Dokumentation: Response Streaming für Lambda-Proxy-Integrationen, einschließlich der Response-Streaming-Invoke-ARN und des STREAM-Response-Transfer-Modes. https://docs.aws.amazon.com/apigateway/latest/developerguide/response-transfer-mode.html; https://docs.aws.amazon.com/apigateway/latest/developerguide/response-transfer-mode-lambda.html
[3] AWS-Bedrock-AgentCore-Entwicklerhandbuch und IAM-Action-Referenz: die InvokeAgentRuntime-Data-Plane-Action, der Inbound-JWT-Authorizer und die eigenständigen InvokeAgentRuntimeCommand/InvokeAgentRuntimeCommandShell-Actions, die Commands ausführen, ohne durch das Modell zu gehen. https://docs.aws.amazon.com/bedrock-agentcore/latest/APIReference/API_InvokeAgentRuntime.html; https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/inbound-jwt-authorizer.html; https://docs.aws.amazon.com/service-authorization/latest/reference/list_bedrock-agentcore.html
[4] Vercel-AI-SDK-Dokumentation: der useChat-Transport und sein UIMessageChunk-Stream-Protokoll, gegen das eingehende Events validiert werden müssen. https://ai-sdk.dev/docs/reference/ai-sdk-ui/use-chat; https://ai-sdk.dev/docs/ai-sdk-ui/stream-protocol; https://ai-sdk.dev/docs/ai-sdk-ui/reading-ui-message-streams
[5] AWS-Amplify-Dokumentation: signIn() verwendet standardmäßig den SRP-Flow. https://docs.amplify.aws/javascript/frontend/auth/switching-authentication-flows/